CPU実験体験記(24er-5班コア係)
CPU実験とは
CPU実験とは、理学部情報科学科3年Aセメスターに行われる実験であり、約4人の班に分かれて「CPU」を1から作るという催しです。目標は以下です。
- minCamlという独自(?)言語で記述されたプログラムとデータファイルを受け取り、プログラムが出力すべきものを生成する。これが有限時間でできることを、「完動している」と表現する。
- 完動した後は、実行時間を短くすることが想定された目標である。
配布されたFPGAボードを使わなければいけないこと以外には、基本的に何の制約もありません。そして、ガイドもありません。初回授業時には、班分けが発表された後は何の指示も出されず、教室が困惑した空気になっていたのを覚えています。
係
4人には係が割り当てられていて、概ね期待された役割があります。
係の分かれ方は時代によって異なる場合があるので、明確にしておきます。24erの年は以下のようになっていました。
- コア係 ... コアを作る(HDL)
- FPUメモリ係 ... FPU及びキャッシュを作る(HDL)
- シミュレータ係 ... シミュレータを作る(C系)
- コンパイラ係 ... コンパイラを作る(OCaml, Rust, その他の関数型っぽい言語)
私はコア係でした。
ボード
配布されるFPGAボードも時代によって変わっています。過去には7コアのCPUを制作してキャッシュも無しで一桁秒代の記録を出していた班もありましたが、22erの年からFPGAボードがグレードダウンされ、許容される回路規模は小さくなり、"キャッシュ"の作成が事実上必須になりました。
自班ハードウェアの方針
色々と独自のアイディアを考えて空想を練っていたのですが、実際に動くものを作り、その過程で様々な制約との応酬を感じることもCPU実験の意義であると思ったので、最終的には既に確立された手法に沿って実装することになりました。
使ったもの
- 高性能コンピュータ技術の基礎 | Hisa Ando | 工学 | Kindleストア | Amazon 最終的に、コア係の私とFPUメモリ係さんはこの本を参考にしながらハードウェアを実装しました。
- ハリス本 インオーダーパイプラインプロセッサについて詳しく書かれていて、普通はこれを元にまず動くコアを作ります。私はインオーダーが気に入らず初めからOoOを書いたのでしっかり読み込みませんでしたが、コード辺を参考にしたりしました。
- verilator 信号が対応していない、ビット数が違うなどの、verilogのコードの怪しい箇所を指摘してくれます。私はお世話になりましたが、FPUメモリ係さんはこういったことが自力でほぼ完璧にできるタイプの人間らしく、使っていませんでした。
使わなかったもの
- ロジックアナライザ "闇"とだけ聞いていたので使いませんでしたが、最後デバッグがかなり炎上していたので検討すべきだったかも?
- LLM 実験の意義を損なわない使い方ができる自信がなかったので、とりあえず使わないことにしました。使っても良いと思います。
自班ハードウェアの成果物
動いたもの
Out of Order の4スレッドコアを作成し、これが動きました。FPUメモリ係さんはOoOに適したキャッシュであるノンブロッキングキャッシュを作成しました。コンパイラ係さんはプログラムの並列性を検知(大変!)するコンパイラを書きました。
動かなかったもの
上記のコアを二つ接続したデュアルコアプロセッサを実装しました。FPUメモリ係さんは二つのコアのキャッシュを調停する仕組みを実装しました。
歴代のCPU実験における自班の珍しい点
ボードの縮小およびキャッシュの登場から3年目の代だったので、いくつかの実績をアンロックすることができました。
- キャッシュが登場してから恐らく二班目のOoOを実装した班(一班目は23erの1位?)であり、恐らく初めてOoOに適したキャッシュであるノンブロッキングキャッシュを実装した。
- キャッシュが登場してから恐らく初めて並列実行向けコンパイラおよびマルチコアを実装した班であり、恐らく初めてマルチコアにおけるキャッシュ調停を実装した。
- マルチスレッドコアを実装した。(回路資源が豊富な旧ボードの場合、並列実行向けコンパイラを書いたら先にマルチコアにした方が効率的であるためか、取り組んだ班が歴代にあまり見つからなかった。)
結果
この年からnegative slackがあるまま合成することが禁止(negative slackを攻めるのが強かったため)され、周波数を上げるのが少しだけ難しくなりました。
自班の "256x256" に対する実行時間は 62.8605 秒で、7班中の2位でした。3位は80秒台、4位は100秒台だったと記憶しています。1位は新ボードでの歴代記録を大幅に更新していました(結果は一応伏せておきます)。
デュアルコアプロセッサが動いていれば、単純に考えれば二倍の速度になっていた(計測に使うプログラムは並列性が非常に高いことが知られています)ので、方針としては悪くなかったと思うのですが、実装しきれませんでした。
とはいえ、(CPU実験としての)新規性のあるハードウェアを作ることができ、実際にひどくない速度が出せたことには満足しています。
謝辞
TODO
𝑩𝑰𝑮 𝑳𝑶𝑽𝑬______
最終レポート
おわりに
院試体験記(東京大学大学院情報理工学院コンピュータ科学専攻2026)
2026年4月入学の東京大学大学院情報理工学院コンピュータ科学専攻 修士課程の夏入試(2025年8月実施)に合格しました
理学部情報科学科の学生なので「内部」にあたる受験生です。
同じ理学部の数学科・物理学科や、同じ情報系の計数・電情は激しい選抜や研究室振り分けがあるのに対して,情報科学科の院試は内部生は概ね希望通りに通るというものと言われています。
ただし、聞くところによると「院試で内部に優遇措置はかけておらず、純粋に点数で区切っている。試験内容的に内部の学生が有利だから内部の合格率が高いだけ」であるようです.過去には得点率が3割程度だった内部生が不合格になったという話もあるようなので,点数は取る必要があります.
また,各研究室には人数の上限の目安のようなものが設けられているとされています.この値は公開はされていませんが,以前の代の所属人数を見れば概ね把握できます.独自に調査をしていた同期によると,内部生の志望は概ねこの定員に収まるようにバラけていましたが,一部超過しているところ,定員ちょうどである研究室などはありました.このような研究室を志望する学生はより熱心に院試勉強をする傾向があります.
筆記試験
筆記試験(点数に換算されるもの)は以下です
- TOEFL(120点)
- 情報理工学院共通の数学の試験 (300点)
- コンピュータ科学専攻の専門科目試験(800点)
合格点のようなものは分かりませんが,内部生の得点の平均・中央値は 850 点前後だったのではないかと予想しています.(よく他人の点数を過大評価するタイプの人がいますが,私はそういったタイプではありません.)
以下,筆記試験に関連する体験記です.
院試ゼミ
学科同期が,7/28から8/14まで週3日のペースで院試ゼミを開いていた。過去問を2年分ずつ各自が解いて来て,情報交換を行うという形式のものだった。私はこれに一回参加した。
TOEFL
5月17日に受けた。
出願が6/5にあり,それまでに結果を送る必要がある。結果が出るまで2週間程度かかる可能性があるとされているので,この受験日はデッドラインギリギリになる。
同期は春休み中や4月に受けている人が多かった。
手続き関連
- ネット上に転がっているクーポンを入れると割引される.私は謎のインド企業のおかげで 15.6 USD 割引された.
- Send scores to institutions をする必要がある.Send scores to institutions は MyTOEFL Homeからだと25 USDかかるがMyTestsからだと無料.
対策
- TOEFL公式が出しているサンプル問題(2時間)を試験前に解いた
- 学科同期がdiscordに書いている知見を見た
結果
- Writing 21
- Listening 21
- Speaking 15
- Writing 19
合計 76 / 120
感想
いつもと同じ程度の英語の分からなさ・出て来なさ具合だったので、実力相応の結果なのだと思う.
同期の平均や中央値は,これよりは高く,これより10点は高くない程度という印象だった。
TOEFLの点数はひととおりの対策をすると学部入試の英語の点数と大体同じになるという噂もあるが、ある学生は完全に対策無しで受験して学部入試から40点近く点を落としたそうだ。
共通数学
8月19日に受けた。
前提
共通数学は100点×3問からなり,それぞれ線形代数、微分積分、確率統計の分野から出題される。
対策
- 院試ゼミに一回参加し,2020, 2021年の数学を眺めて少し解いた
- 過去問の線形代数の大問を見て,学部1年レベルの線形代数の復習
- 過去問の微分積分の大問のうち,常微分方程式の回でないものをいくつか解いた
結果(自己採点)
- 線形代数 55
- 微分積分 10
- 確率統計 85
合計 150 / 300
感想
微分積分の大問では,Riccati 型微分方程式をテーマとした問題が出た.
私は常微分方程式に関して無知(知っていることは,何か色々なタイプがあるらしいということと,学部1年の物理でやった減衰振動くらい)で,各設問30秒ほど考えて諦めた。
出題傾向的に今年は常微分方程式でない問題が出ると思ったことと、あと単に常微分方程式に興味が無かったため、勉強はしていなかった。学科のカリキュラム・方向性上、同期も常微分方程式に明るい人間ばかりではなかったが、取れたのが小問一つのみというのはその中でもやりすぎだったようだ。
同期の平均や中央値は,これよりは高く,これより50点は高くない程度という印象だった。
計数数理の学生には(例年通り?)全完セットだったようだ.
専門科目
8月20日に受けた
前提
専門科目は200点×4問からなり,形式言語,アルゴリズム,ハードウェア,OS (処理系・機械学習の年もあり) の分野から出題される.
対策
- 院試ゼミに一回参加し,2020, 2021年の問題を眺めて少し解いた
- 過去問の形式言語の大問が面白かったので色々解いていた
- 過去問のアルゴリズムの大問を一つ解いた
- 過去問のハードウェアの大問を一つ解いた
- 過去問のOSの大問を見て,忘れていた知識を復習
結果(自己採点)
- 形式言語 150
- OS 60
- ハードウェア 200
- アルゴリズム 200
合計 610 / 800
感想
形式言語の大問の最後の小問は,解法がシンプルでありそれなりに解かれていた.私は方針を誤り,長い時間を掛けたものの時間内に解けなかった.
OSの大問では,ページングをテーマとした計算問題が出たが,うまくイメージがまとまっていなかったため,ケアレスミスのような知識不足のようなミスでかなり失点してしまった。
アルゴリズムの大問については,最後の小問をやり残した人が多かったように見受けられた。
同期の平均や中央値は,これから ±50 に収まる程度という印象だった。
(余談:アルゴリズムの大問を作成している教員が昨年・一昨年とは異なることが容易に想像できた.)
面接
研究計画書
6/5の出願の際に,研究計画書を出す必要がある.この学科では卒論の配属はB4の前期では決まっておらず,代わりに演習Ⅲという授業で3つの研究室を一ヶ月ずつ回ることになる.演習Ⅲで志望研究室を訪問した際のテーマに沿って研究計画を書いた.
念のため体裁を整えておこうと思って,引用のフォーマットを見本に揃えるなどに注意したが,気にしている人は多くなかったので問題ないのかもしれない.
面接
8/25 にZoomで行われた.他の参加者の名前が見えないような,普段と異なるモードで実施されていた.
指定時間(11:50)までに待機室に入るよう指示されていたが,待機室が待機室らしい見た目をしていなかったため,待機室に入れていないという勘違いが生じていた。

研究室の分野・方向性ごとに3つの面接室が設けられており,順番になると突然そこに呼び出される形式だった.面接は5分ほどで終わった.
質問内容
- 志望理由を1分で
- この研究計画の後の野望はあるか?
- 修士課程の後の進路
野望を聞かれるのが珍しいと思ったが,このような経緯によるものだった.

おわりに
微分方程式やOSの筆記試験の結果を考えると自分のパフォーマンスは褒められた内容ではなかったように思いますが、志望の研究室に合格できたようで良かったです。
受験者の方へ
外部の方
試験範囲が理情の必修科目に含まれているため内部生は得点を取りやすいと言われていますが,問題そのものはオープンなものにするよう配慮がされていると感じました.
- 形式言語の大問は,Sipser(?)などのオープンな演習問題と類似した問題が毎年出されており,対策がオープンな資料で完結します.透明性確保の意味もあって,この大問が毎年実質的に固定された枠として置かれているのではないかと思います.理情では2年秋学期に「形式言語理論」という授業があり,その期末試験で同種の問題も出されますが,それ以降は形式言語理論の演習問題を解くことはなく,院試で改めて取り組むことになります.
- アルゴリズム・離散数学は、同じ情報系の学部でも大学や学科によって授業で扱っている内容がそれなりに異なるという印象を持っています.理情の3年春・秋学期では現在はグラフ理論を切り口とした離散数学/計算量理論の授業が行われており,2024, 2025 年はそのような問題が出題されました.一方,2026年の問題はそのようなものではなく,理情の学生は2年生までの基礎的なアルゴリズムの授業の知識および常識・素養で取り組んだことになります.
- OS・ハードウェアの大問では,授業の方針や選んだ資料によって扱うかどうかが変わり得るような知識の要求を減らすような配慮がされていると思いました.
内部の方
- TOEFLは春に受けている人が多かったと思います.過去にTOEFLが40点台だった人は面接の時に説明を求められ、「時間をかければ論文の英語を正しく読むことはできる」などのように答えたそうです.
- 6月には共通数学や専門科目の対策を始めている人が例年多いと思います.
- 詳細はぼかしますが、年に1人程度、点数不足あるいは手続き不備によって内部生が不合格になるケースもあるという噂もあります.そのようなことが無いよう願っています.
Pseudoforestの補グラフの最大マッチング
Pseudoforest(擬似森)の補グラフの最大マッチングのサイズと,それを構成する線形時間アルゴリズム
Tutte-Bergeの定理の練習
#毎日Duality 2025/7/13 出題
N頂点のPseudoforestに対して、以下の最大化問題の答えは?
— ⋆꙳.*・ (@Segtree) 2025年7月13日
補グラフの最大マッチングのサイズ#毎日Duality
平方分割による活性解析アルゴリズム
この記事は 理情 Advent Calendar 2024 - Adventar の12日目の記事として書かれました。
不幸にも前日の記事はありませんでした。
はじめに
コンパイラにおける「活性解析」に関して競技プログラミング形式の問題を作ったが、質や準備の大変さ的にコンテストに出せるようなものではないため、記事として公開する。
活性解析とは
プログラム中で、変数が生きている/死んでいるというのが定義できるので、それを計算すること。
データフロー解析の一種で、プログラム中の変数をレジスタへ割り当てる際などにこの結果を用いる。
コンパイラでは「構文と向き合う」というテイストのパートが多くあるが、活性解析はその中では数理的(?)で個人的には親しみやすいものであった。
問題
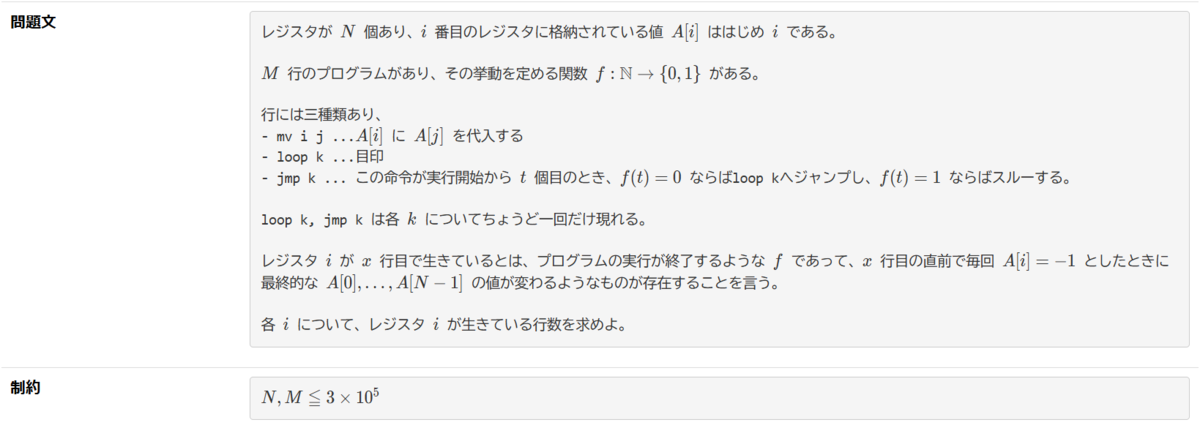
一変数を一変数に代入するという単純なプログラムにおける活性解析をモデル化した問題である。愚直なアルゴリズムとしてO(NM)のものが知られている。
解法
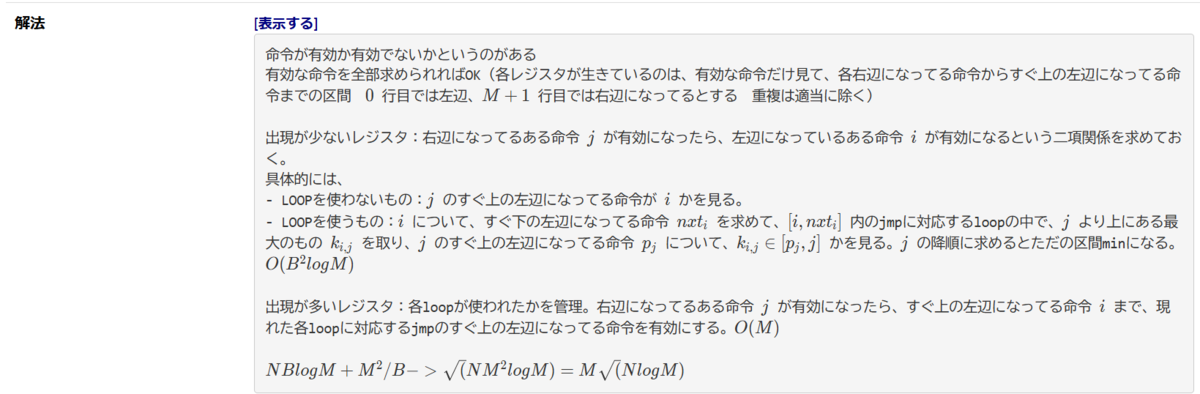
「出現が多い変数とそうでない変数で解法を分ける」という平方分割を行う。
分けた後はいつもどおり頑張る。
計算量はO(M√(NlogM))。
答えは各変数が生きている区間の集合という形で求まる。
おわりに
活性解析のO(NM)のアルゴリズムが授業で紹介されたときに、「疎性を真面目に使えばこれよりは速くなるね」と思ったので、それを詰めて問題にした。
実際は、活性解析は関数単位で行い、その内部の変数の数は通常十分に小さく3×10^5もないので、高速化が求められる場面は恐らくあまりないとされている。
(補足:配列は通常先頭アドレスだけ見て一つの変数として扱うため、O(N)より多くの変数を扱うことにはならない。)
各行で生きている変数の集合を増やしていくという素朴なアルゴリズム(トポロジカルソートに近い実装になる)がO(NM)で動くため、実際のコンパイラでは、使われるのであれば概ねこのようなアルゴリズムが使われているようだ。万が一大きな入力が来た場合には、規定のアルゴリズムから挙動を変えることなく、「単に止まらない」という実装が多いらしい。
頂点被覆バトル
この記事は 理情 Advent Calendar 2024 - Adventar の9日目の記事として書かれました。
前回はtaka2さんの記事でした。
はじめに
一之瀬、Segtree、TAISAの3人で「頂点被覆バトル」を行った。
「AIじゃんけん大会 - Segtree’s blog」に引き続き、ゆるくプログラムを書いて遊ぼうという会である。
今回の提案は私で、大昔のAtCoderオンサイトでグラフ彩色問題に対して同様のものがあったと聞いたため、それにヒントを得た。
ルール
頂点被覆問題に取り組む。
各プレイヤーは、solver(グラフが与えられたときに、できるだけ小さな頂点被覆を返すプログラム)と、テストケースとその想定解(グラフとその頂点被覆の例)をひとつづつ作る。
総当たりで各solverに各テストケースを入力として与え、solverの解と想定解の頂点の数の差分が各プレイヤーの得点/失点になる。例えば、プレイヤーAのsolverにプレイヤーBのテストケースを与えたときに、プレイヤーAのsolverの解が4000頂点、プレイヤーBが作った想定解が3000頂点だった場合には、プレイヤーAに-1000点、プレイヤーBに1000点が入る。この総和で順位を決める。
グラフのサイズは N, M <= 10000 で、実行時間はその場の気分で決めることになった。
solver
一之瀬
各頂点について「必ず選ぶ」「選んでも選ばなくてもよい」を決め、これに関して山登りを行う。「選んでも選ばなくてもよい」とした頂点集合による誘導部分グラフに対して、葉があれば切った上で、貪欲法を行ってスコアを計算する。
Segtree
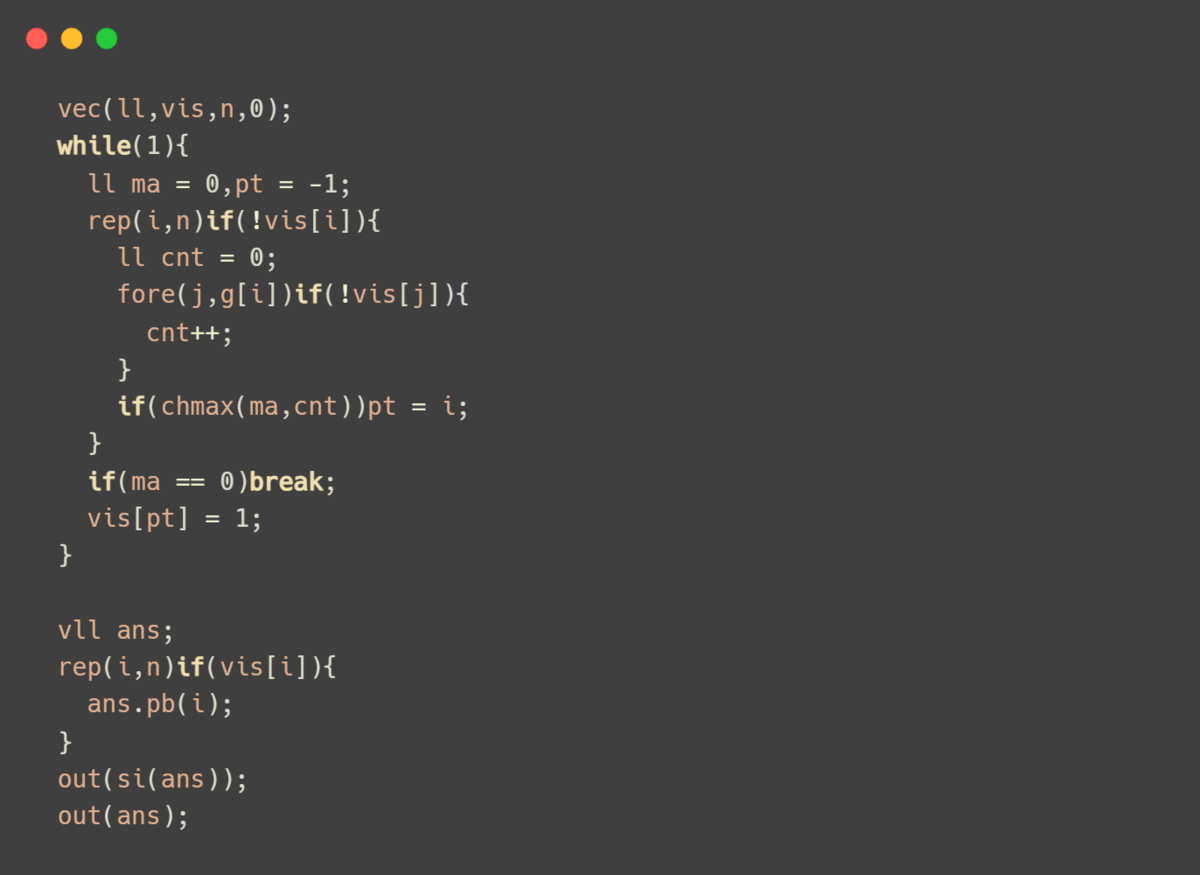
単純な貪欲法。
「次数の大きな頂点を頂点被覆に追加し、それに隣接する辺を削除する」ことを繰り返す。
葉を切っていくなどの他の愚直なヒューリスティックでも落ちない反例がそこまで自明ではなかったので、これを落とすのはそこそこ大変だろうと思ってこのまま投げた。
TAISA
極大マッチングを使った2近似アルゴリズムを実装していた。
辺を見る順番によって解が変わるが、この順を山登りしていた。

testcase
一之瀬
N=7129, M=10000
想定解:3565
貪欲キラーを何時間かプログラムを回して生成したらしい。
・vs. Segtree(solver)
4409 (+844)
・vs. TAISA(solver)
4568 (+1003)
狙い通りしっかり貪欲法に対策ができており、貪欲法的なアプローチをしていたsolver側に対して1000近い差を生み出すことに成功していた。
Segtree
N=6875, M=9999
想定解:3125
以下のように、11頂点15(+1)辺の小グラフを繋げたものである。
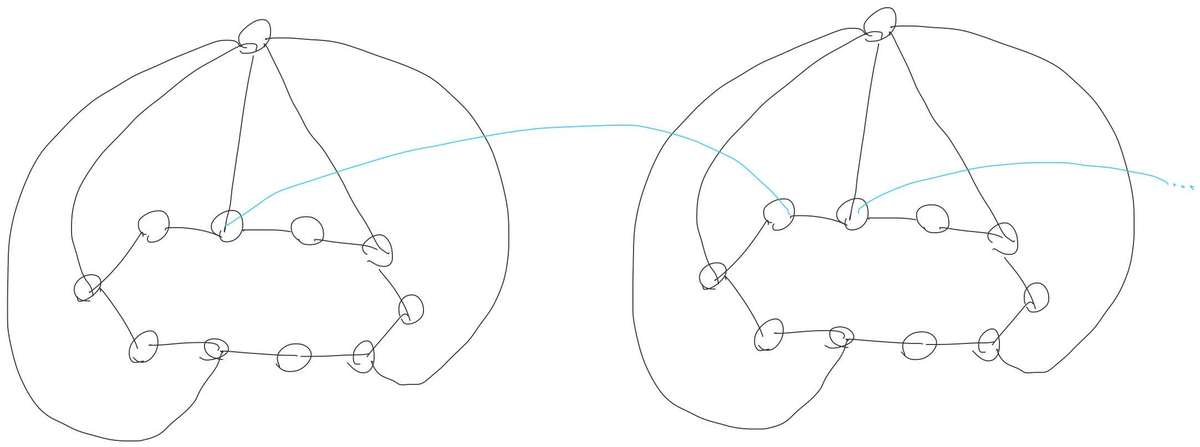
各小グラフは、自分の書いた「次数が大きなものから取る」という貪欲法に対するキラーケースになっている。輪の部分の10頂点から上の1頂点に繋がっている5つを取れば頂点被覆になっているが、貪欲法では上の頂点も取って6つを取ることになり、差が生み出せる。
・vs. 一之瀬(solver)
3129 (+4)
・vs. taisa(solver)
4670 (+1545)
一之瀬solverは「いくつかの頂点を適当に選んで削除してしまい、葉に隣接する頂点は削除する」ということをしており、輪の部分で一つ偶奇の正しい方を選んで削除すると自動的にすべて正しい方を選ぶことになるため、ほぼ最適解を導いていた。元のグラフにおいて葉を切る貪欲が効かないように輪の形にしていたが、部分的に頂点を削除したときには葉が発生することになることがポイントだった。
一方、TAISA solver(2近似アルゴリズム+山登り)に対しては、一つの小グラフが11頂点と小さかったことによって山登り法での辺の入れ替えにおける近傍内に有効なものがより少なくなり、より大きな差を生み出すことに成功していた。
終了後に、二部グラフであることが指摘された。二部グラフの最小頂点被覆は最大フローに帰着され、辺の重みがすべて1であるからO(N√M) で解ける。そのため、N,M <= 10^4であれば十分高速に厳密解が求められる。

TAISA
N=10000, M=5627
想定解:3500
テストケースを作る際、相手のsolverの出す解のサイズを大きくすることも重要だが、自分の用意する想定解のサイズが十分に小さいことも必要である。TAISAのグラフは、N=20の小グラフをランダムに生成してその最小頂点被覆を求め、それらを最適性が失われないように繋げて連結にしたものである。
・vs. 一之瀬(solver)
3500 (+0)
・vs. Segtree(solver)
3500 (+0)
どちらのsolverの解も想定解とぴったり同じサイズになった。
元のN=20の小グラフが簡単なものであり、貪欲法によって最適解が求まるものだったのだと思われる。
本人は0を下回らなかった時点で目的は達成できていると主張していた。
総合結果
1位 一之瀬 +1843pt
2位 Segtree +705pt
3位 TAISA -2548pt
solverもグラフも強かった一之瀬が優勝した。
TAISAのグラフはN=20のグラフの中で良いものを引き当てることができれば健闘しただろう。
振り返り
頂点被覆と独立集合は補集合の関係にあり、最小頂点被覆と最大独立集合が同じ問題であることが知られている。
最大独立集合問題はNP困難であるが、厳密解を求めるアルゴリズムであって、指数の底が小さく、実際にはより高速に動作することが期待されているものが存在する。
指数時間アルゴリズム入門 | PPT
はじめは速く動作することを期待してこれを書いてしまおうかと思ったが、実際には全員が小さなグラフをパスやサイクル状に繰り返すという方針を取っており、そのようなグラフでは10^4頂点では実行が終わらないところだった。このアルゴリズムの「次数が大きなものから選ぶか選ばないか決める」というパートで2^{小グラフの個数} の分岐ができてしまうため、一番小グラフの個数が少なかった一之瀬グラフでも2^99回規模のDFSの呼び出しが必要になる。
逆に、大きな構造としてパスやサイクルに近いということは、木幅が小さいということが推測されるだろう。木幅が小さなグラフに対しては、木分解を行った上でDPを行うという、木幅を定数として線形時間の厳密アルゴリズムが知られている。
木幅と線形時間アルゴリズム - blogoid
N,M <= 10000 という制約となった時点で参加者が作るグラフの木幅が小さいことが期待されるため、木分解上のDPを書くという戦略も有効だったかもしれない。
AIじゃんけん大会
この記事は 理情 Advent Calendar 2024 - Adventar の2日目の記事として書かれました。
ちなみに1日目の記事は無いらしいです。
はじめに
一之瀬、ひらきち、Segtreeの3名でじゃんけんAI大会を行った。
大会といっても、競技性をしっかり考えてレギュレーションを組んだり全身全霊で競争をするというものではなく、ゆるくプログラムを書いて遊ぼうという会である。
ルール
それぞれの人が、じゃんけんAIプログラムを書く。
じゃんけんは人間対AIで行われ、100回じゃんけんを繰り返す。
AIプログラムは対戦が始まってから相手の出した手の情報に応じて手の出し方を変えることができる。
詳細
人間 vs AI の形の総当たり戦を行う。(N人の場合、N(N-1) 回の対戦が行われる。)
それぞれの対戦では、google spreadsheet上でじゃんけんを100回行う。
google spreadsheet 上で対戦を行うことによって、プロンプト形式で対戦する場合に比べて、人間側が過去の手を確認しやすくなっている。
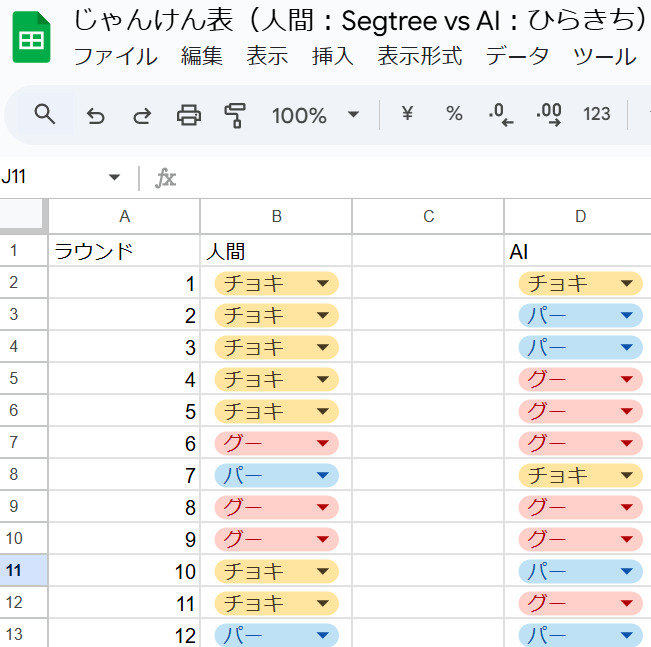
AIの勝利数 + 人間の勝利数によって順位を決める。
勝利数のみによって順位が決まるため、複数人のプレイヤーが「お互いが対戦するときは50勝50敗0分になるようにしよう」などと約束すると順位が上がってしまうので、それが禁止された。
追加ルール:裏工作禁止
各AIの特徴と対戦結果
各参加者が作ったAIの特徴と、そのAIと人間の対戦結果をまとめる。
一之瀬AI
相手の手を統計的に処理
相手が出した手、手の変化のしかたの傾向をカウントし、それに応じて手を出す。
・vs. ひらきち(人間) 人間側があまりに偏った手を出したことによって、AIが同じ手をずっと出すようになってしまい、人間側に手を読まれてしまった。ずっとパーを出していたらしい。 25-48(人間 +23)
・vs. Segtree(人間) これも同様に、人間側の手が偏っていたことによって、AIが似たような手をずっと出してしまい、人間側に手を読まれてしまった。 29-40(人間 +11)
ひらきちAI
相手の手の出し方に特定の特徴があったらそれを読んでアンチパターンを送る。主に前の手との差分に注目していた。有限オートマトン形式だった。
・vs. 一之瀬(人間) なぜか人間側は自分のAIで打っていたらしい 34-36(人間 +2)
・vs. Segtree(人間) 「負けた後は自分に負ける手を出す」のような法則を人間側が読んで優位に立ってはいたが、同じことをずっと続けているとAI側が法則を破ってくるという仕組みになっておりやや手強かった。 31-42(人間 +9)
Segtree AI
これまでの対戦結果の履歴が使えることを無視し、相手の手によらず一定の手の列を出す。
mod 3で見た時の前の手と現在の手の差分が0 -> 1 -> 2 -> 0 ... と一定時間ごとに変化するようにした。
人間の雑な予測に対するアンチパターンになり、ランダム以上に勝利数を稼ぐことを狙った。
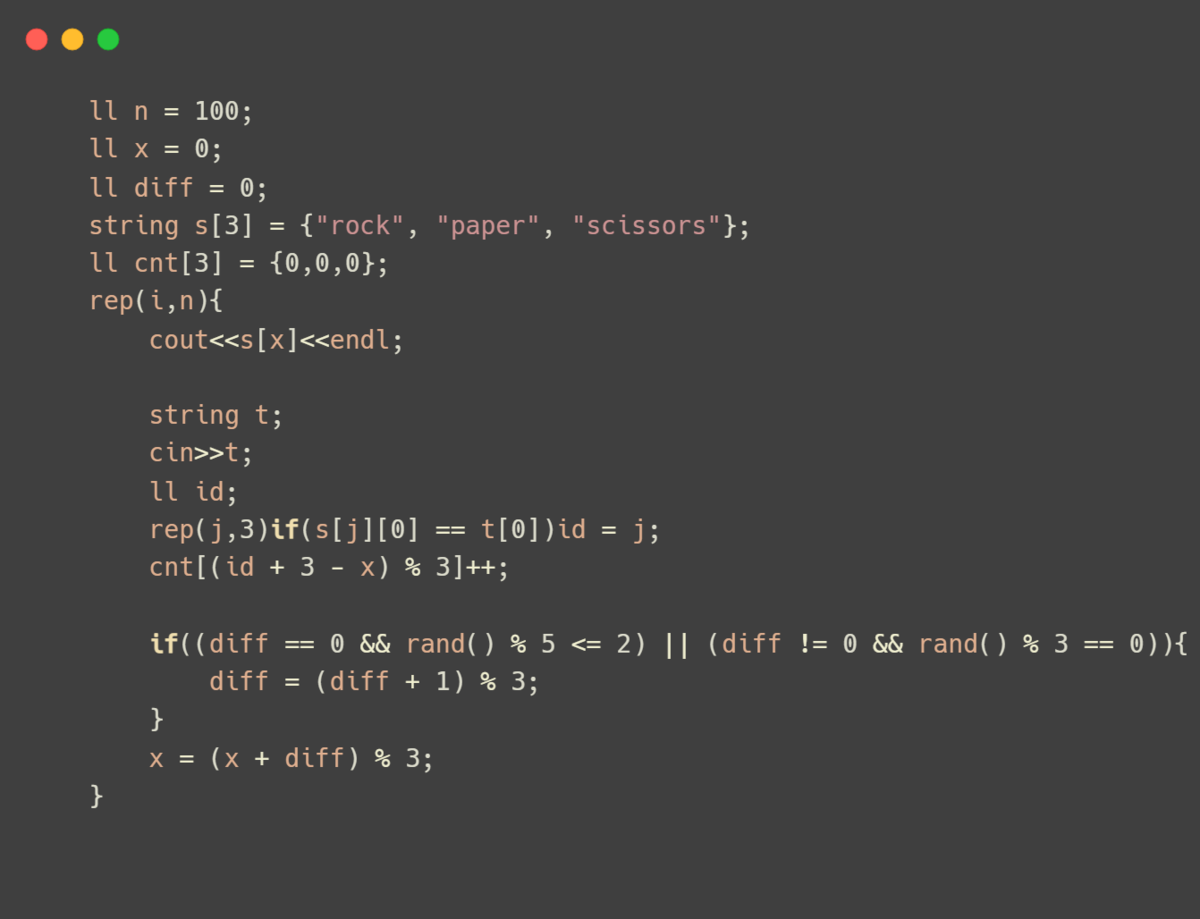
・vs. 一之瀬(人間) なぜか人間側は自作のAIで打っていたらしい 38-31(AI +7)
・vs. ひらきち(人間) 出力がConstantであることをうっかりもらしてしまい、人間が100回常にグーを出していた。 AIの生成した列に偶然チョキが多かったので、人間の勝ちが多くなった。 29-37(人間 +8)
総合結果
1位:ひらきち 150勝 132敗 118分
2位:Segtree 149勝 128敗 123分
3位:一之瀬 128勝 167敗 105分
1勝の差でひらきちが優勝した。
一之瀬AIに対する人間の勝数で大きな差が付いたようだ。
一之瀬AIは一行変えることによって相手の偏りに釣られて自分が偏ってしまうことを防ぐことができ、改良が見込まれるらしい。
考察
6戦のうち5戦で人間側が勝利しており、「人間がAIの挙動を読んで勝利する」ということが多かったことが分かる。
このとき人間が行っていたことはどのように解釈すれば良いか、プログラムで書くとすればどのようになるのか?という自然な疑問が生まれる。
万能じゃんけんAI
プログラムMが万能じゃんけんAIであるとは、
「あるクラスに属する任意のAIプログラムM'に対して、ある手数N (=f(M,M') )が存在して、MとM'を対戦させたときにN手以降で相手に全て勝つ」
ことを言う。
いくつかの対戦相手AIプログラムのクラスに対して、万能じゃんけんAIが存在するかを議論する。
相手のAIプログラムに時間制限がある場合
相手のAIプログラムについて「あるステップ数 k が存在して k ステップ以内に次の手を出す」ということが保証されている場合、そのようなクラスに対しては万能じゃんけんAIが存在する。(1ステップをどのように取るかには様々な方法があるが、例えばチューリングマシンへ帰着したときの1操作を1ステップとすればよい。)
構成
(あるチューリング完全な言語において)単純な方からプログラムを順に見ていき、相手のプログラムとしてこれまでの情報と矛盾しない候補を一つ管理していく。「実際にプログラムを実行し、k ステップ以内に結果を返さなかった場合や、出した手がこれまでの情報と矛盾したら現在の候補を棄却して次の候補に進む」ということを繰り返す。
相手のAIプログラムもしくはそれと今後の一切の実行において等価なプログラムに有限時間で辿り着くため、ある有限のタイミング以降では相手の手を完全に予測することができ、勝つことができる。
相手には時間制限があり、自分には時間制限が無いことがポイントである。
自分に一定の時間制限が付いていてもその値が十分に大きければ同様のプログラムが組めるが、どの程度まで時間制限を縮められるかは言語やステップ数の取り方依存である。ただし、時間制限が自分と相手で等しかった場合には不可能であることが示せる。(後述の議論と同様)
相手のAIプログラムのクラスに万能じゃんけんAI自身が含まれないことがポイントである。
相手のAIプログラムに有限時間で停止する以外の条件が無い場合
一定の時間制限があった場合には「実際にプログラムを実行し、時間制限まで待って、その結果出した手がこれまでの情報と矛盾したら次の候補に進む」ということができたが、一般の場合には停止しないプログラムが候補として挙がっていたときに、実際に何秒まで待てば良いかが決められないため、そのようなことができない。
このクラスに対して万能じゃんけんAIが存在しないことが簡単に証明できる。
不可能性の証明
万能じゃんけんAIプログラム自身もこのクラスに属する。そのため、二つの万能プログラムM1, M2どうしを対戦させることができる。f(M, M') をその手数以降 M'に対してMが常に勝ち続けるある手数とする(定義参照)。max( f(M1,M2), f(M2,M1) ) 手以降で、M1がM2に勝利し、M2がM1に勝利することになるが、これは矛盾。
結論
人間も万能じゃんけんAIと同様に、相手のプログラムやその挙動として考えられる候補を実際の挙動をもとに順に絞っていくというような戦略を取っており、これは素朴な統計的なプログラムに対して優位な戦略だったと言える。相手に完全に勝ち切る「万能じゃんけんAI」は、対戦する二者が対等な条件であれば存在せず、一手に掛けられる時間の差が十分にあれば時間が長い側にのみ存在する。
ICPC Asia Yokohama Regional 2023/24 参加記 (segtree 視点)
チーム
Speed Star (noimi, SSRS, ynymxiaolongbao)
どうしてこうなっているかというと、学内のAtCoder四~五段くらいの勢力(伝われ)が決まった3人組でICPCに出がちであるためです。
コンテスト前
コンテスト一週間くらい前に何か「自分が勉強しておくと良いものはあるか?」と聞いたらnoimiさんに「マトロイドとか?」と言われたので、マトロイドを勉強する。twitterで検索するとICPC作問陣にもいるYYさんやoptさんがマトロイドや劣モジュラ系を推していることが分かり、ますますやらないといけないなとなる。(実際にJ問題はYYさん原案のマトロイドだった。本番ではnoimiさんが「凸だから貪欲ができて」と言って解いていた。自分はマトロイドであることに気付いていなくて、解説を聞いて、その後の懇親会でYYさんに直接質問してやっとマトロイドであることを理解した。)
コンテスト結果
結果:全完(11完)4時間0分 ペナルティ無し

コンテスト中
・すべて時系列に書いていて、太字はその時刻にACした問題と実装者、問題概要です。
・すべてsegtree視点で書かれています。また、SSRS/noimiが何をやっていたかは微妙に違う可能性もあります。
初動
segtree: PCを触る(ログイン,エディタ立ち上げ,コンパイルコマンド設定など)
noimi: segtreeが準備してる間にA,Bを読んで解いておき、終わったら書き始める
SSRS: C以降のすべての問題を読む(←10分でできるらしい)
PCを触り終わって、すべての問題を眺める。
A(0:08) 実装noimi YOKOHAMAを作れ
すべての問題を読み終わったSSRSにどうするか聞くと、FとDが簡単で、「FをやるのでDを読んでください」「区間DP」と言われる
noimiがBの読解で詰まったので、SSRSがFを書き始める。
F(0:12) 実装SSRS グリッドで市松になるやつ
Dの問題を理解して、解けたので、疑似コードを書く。
noimiとSSRSが相談してBが解決した。実装はSSRSがやるらしい。
noimiがHを解いて、実装に移る前のSSRSに説明している。
B(0:25) 実装SSRS(?) 列を分割するやつ
Dを書き始める。10分くらいで書き終わって、サンプルを試すと、変な答えが出てきた(具体的には、正解が "3(ab)5(a)" の所で、"a"と出て来た)。こんなの直らない訳がないんですよね~(笑)と思っていたら、SSRSに「大丈夫!?!??」と聞かれたので、「大丈夫じゃないです」と言い、コードを印刷してPCを渡す。
多分このタイミングでSSRSがG、noimiがEを解いていた。
noimiがHの実装を始める。自分は印刷したコードを見て間違いを探す。Hの式とかを詰めるのにたまにPCが開くので、そこで直していく(直したら今度は答えがinfになってしまった。悲しい。)。そういうことを何回かやると、サンプルが合った(本質的なミスは、区間DPをrep(r,n)rep(l,r)にしていたこと)。申し訳ない。
D(0:53) 実装segtree 区間DP
進捗表(各問題の所感、解けたか、ACしたかなどを管理している表)を見ると、この時点で
・ACした:A B D F
・解けた:E G H
・解けてない:C I J K
になっていた。
分野としてCに998、IとKに幾何と書いてあって、それはnoimi/SSRS担当なので、Jを見ることにする。
Hの実装が終わったらしい。
H(0:57) 実装noimi 燃やす埋める
Jを考える。DP高速化とか貪欲(想定解のではなく、山登り的なもの)とかを考えていた。
E(1:10) 実装noimi O(2^n*m)
Kが初めて台湾のチームに解かれた。noimiに「Jは知識の可能性があるからK見てくんない?」と言われたので、Kに移る。
G(1:14) 実装SSRS カードの枚数が5/6倍になる998
ここで実装キューが空になった。7完していて、順位表を見ると2位は5完だった。
暫くの間、SSRSは多分C、noimiは多分Jを主に見ていた。
noimiに「Kはどう?」と聞かれ、そこから3人でKについて話す。
色々話しているうちに、SSRSが「1ずらすと算数でできる」と言って、それで解けた(線分が聞けることを使わず直線のみで解いた)。
SSRSがKの実装を始める。
noimi/segtreeでJを考える。暫くするとnoimiが解けて、解法を聞いた(HLDを使う貪欲の方)。合ってそう。
この時点で進捗は
・ACした:A B D E F G H
・解けた:J K
・解けてない:C I
になっていた。
CとIはどちらもこの時点ではどこにも解かれていなかった。いつもの"難問"しか残ってない状況になってしまった。
Cは998のn=3e6でFPS感があり、not for meなので、Iを見る。
K(1:47) 実装SSRS 円の場所と半径を当てる
Jを実装するにあたって、ei133333's libraryのHLDの変数の命名規則がnoimiと微妙に違って書きにくいらしく、SSRSが空でHLDを書き、noimiがその他を書くことになった。
Iを考える。noimiがベクトルで幾何的に考えていたので、自分は濃度の方針で考えることにした。二人が実装している間に解法が分かった。証明はしっかりはしていなくて、書き下せないが可能そうという感じだった。
J(2:13) 実装SSRS+noimi 木でコストが個数の二乗の最適化
二人にIの解法を説明する。SSRSはいつも通り「本当に!?」と言ってきて安心した。noimiが「実装そんなにかからなそうだしとりあえず書いてみよう」と言って、noimiが書き、残りの二人がそれを後ろから眺めて指摘を入れる体制になった。サンプルが合って、提出すると、通った。嬉しい。
I(2:34) 実装noimi 液体を混ぜるやつ
この時点で進捗は
・ACした:A B D E F G H I J K
・解けた:
・解けてない:C
になっていた。
Cは、ポリアの数え上げ定理で周期ごとにした後、周期2なら(縮約後)回文であることまで考察が進んでいた。すぐに、周期任意でも回文であることが示された。
その後は、カタラン数の母関数が~という話になってよく分からなくなったので、modintのライブラリを写経し、サンプルで遊んだりしていた。
二乗logが分かったらしく、noimiかSSRSが書き始める。それを眺める。サンプルが合った。
オーダーを落とすための議論が始まったので、眺める。
移項とか変数変換をすると畳み込みの形になってオーダーが落ちたらしい(?)
二乗logのコードをnoimiやSSRSが一箇所ずつ書き換え、その度にサンプルが合い続けているか確認する。オーダーが落ちている。
最後の確認になって、懐に温めていたn k=1 1を言うと落ちて、k=1の例外処理が追加された。
C(4:00) 実装noimi+SSRS 括弧列的なのの数え上げ
noimiが「凍結間に合わなかった~」と言っていた。
場所が出口近くだったので、弁当を食べるとトイレに来たチームに全完したとバレるかもと心配したりもしたが、お腹がすいていたので食べた。
全問題の復習と反省をした。
segtreeがDに時間がかかったので、代わりにnoimiがどれくらいで書けるのか試したりしていた。noimiがそれを提出しようとしたが、resubmissionで変なことになったら怖いということでやめた。
あとは順位表を見たりしていた。
振り返り
二人が爆速であるとはいえ、自分が一番早く考え始める問題というのは必ずあって、それが早く解けてれば結構タイムが縮まるし(失敗例 K、成功例 I など)より難しいセットなら完数にも寄与するはずなので、自分は変な高難度に特化しようとするより普通に実力を上げるのが良さそう。
